靠人记文件位置
资料散在不同文件夹里,换个人来往往就找不到。
公司里最费时间的检索方式,是那句“大概在哪个文件夹来着”。我们保留原件,另建目录和离线检索:输入关键词就能找到结果,也能回到原始文件的位置。AI 负责归类和挑出冲突,人判断哪份仍然有效。
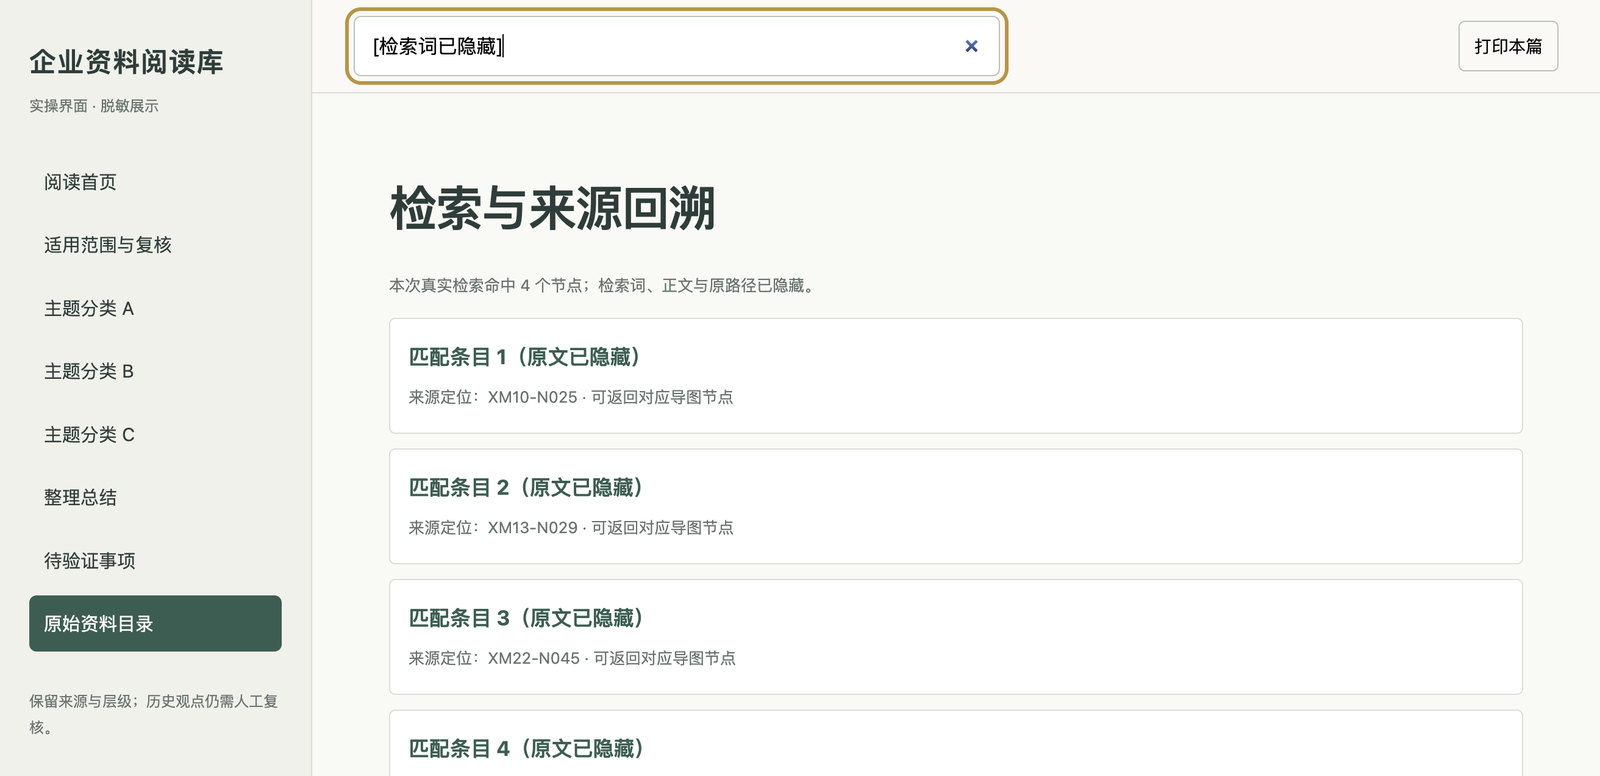
目录结构和检索过程真实,客户与内部正文已隐藏
每个人按自己的习惯存文件,同一内容留下多个版本;即使搜到答案,也不知道它是否还有效、原文到底在哪里。
资料散在不同文件夹里,换个人来往往就找不到。
看起来都差不多,分不清哪份最新、哪份已经过时。
找到一份结论,却说不清它从哪来、原始资料在哪。
原件一个不动,另建目录和离线检索。下面是一次真实检索的完整过程。
这些数字只说明本轮整理范围,不代表所有内容都已经过事实验证。
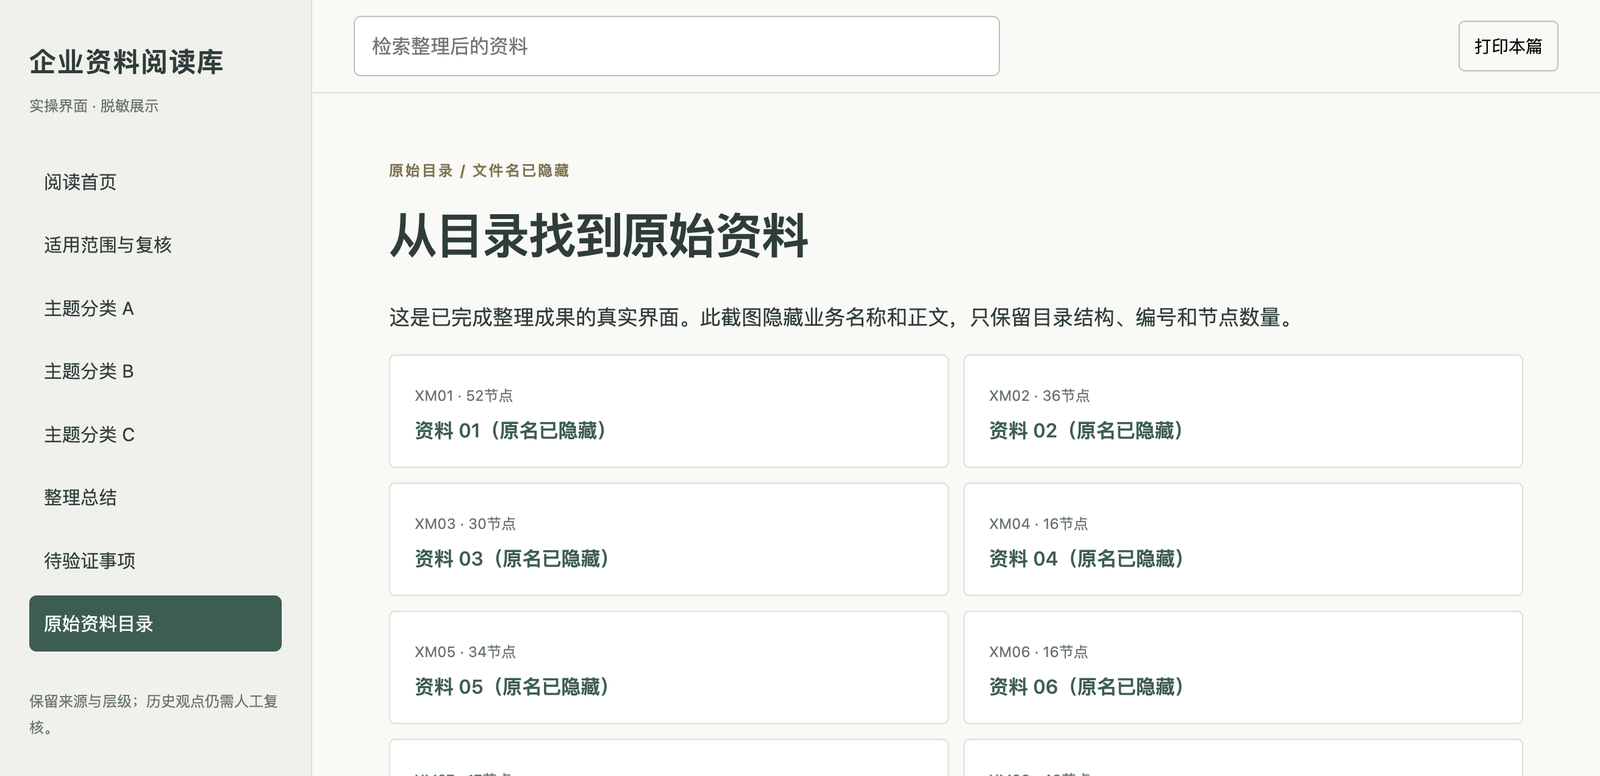
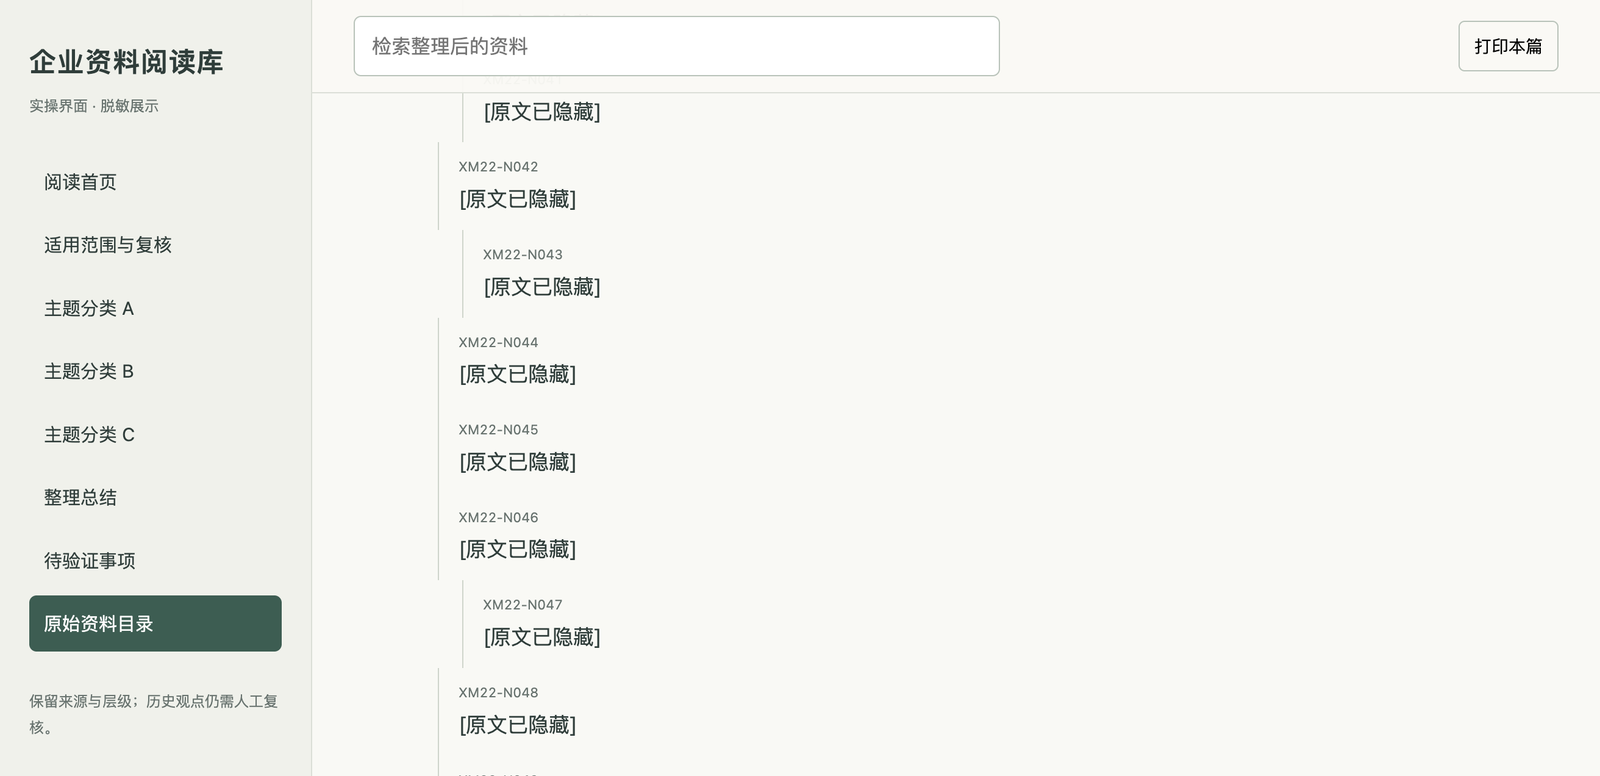
AI 把文件按主题归类并建立关键词索引;人确认哪个版本有效、哪些内容能公开。搜到答案时,必须能回到原文件。
AI 负责把资料变得容易找,人负责判断内容是否仍然正确、适用和可公开。
页面展示的是已经完成的一组 XMind 资料整理证据;课堂不限定格式。学员可以带一小批常见的 PDF 图册、Excel 报价单、Word 合同或扫描件,先把方法完整跑一遍。扫描件能否识别,现场先抽查。
让 AI 看看你的文件和文件夹,先给一版归类建议。
让每条结果都带出处,能回到原文件核对。
把互相矛盾的内容挑出来,等人判断,不让 AI 自己合并。
写清哪些内容可能已经过时,哪些信息不能对外公开。
课上带一小批自己的文件,练目录整理、关键词检索和来源回溯;规模可以小,方法要完整。