ファイルの場所を記憶するのを人に依存する
情報はさまざまなフォルダーに分散されており、誰かが出入りすると見つけることができません。
社内で最も時間がかかる検索方法は、「おそらくどのフォルダにあるか」という検索方法です。オリジナルを保持し、新しいディレクトリを作成してオフライン検索を実行します。キーワードを入力して結果を見つけることができ、元のファイルの場所に戻ることもできます。 AIは紛争の分類と整理を担当し、人間はどれがまだ有効であるかを判断します。
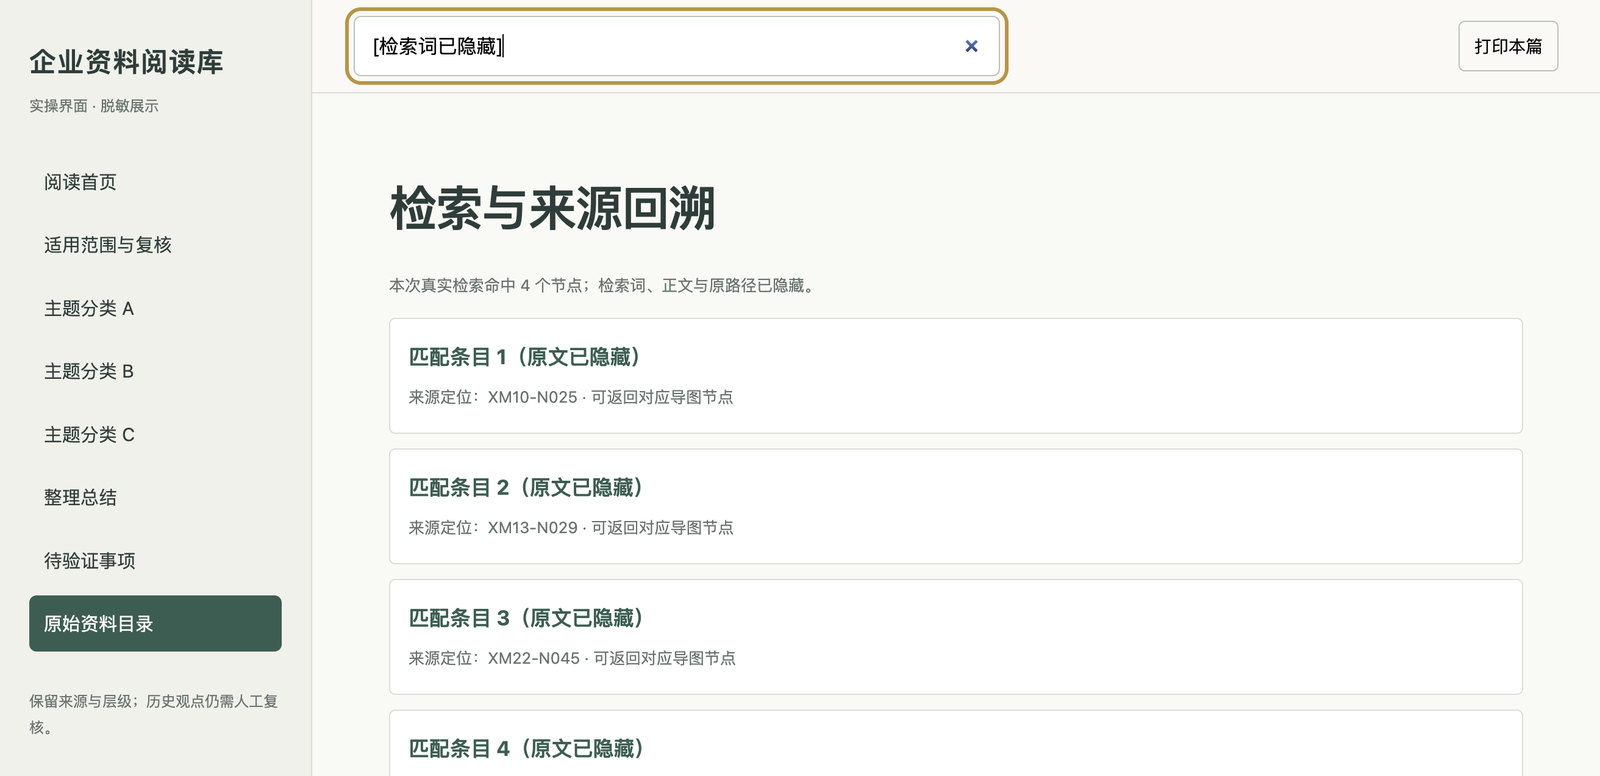
ディレクトリ構造と取得プロセスは正しく、クライアントと内部テキストは非表示になります。
誰もが自分の習慣に従ってファイルを保存し、同じコンテンツの複数のバージョンを残します。たとえ答えが見つかったとしても、それが今も有効であるかどうか、また元のテキストがどこにあるのかはわかりません。
情報はさまざまなフォルダーに分散されており、誰かが出入りすると見つけることができません。
どれも同じように見えて、どれが最新でどれが古いのかを見分けるのは困難です。
結論は見つかりましたが、それがどこから来たのか、元のデータがどこにあるのかわかりません。
オリジナルはそのままにして、別のディレクトリを作成し、オフラインで検索します。以下は、実際の検索の完全なプロセスです。
これらの数字は、今回の統合の範囲を示しているだけであり、すべての内容が事実確認されたことを意味するものではありません。
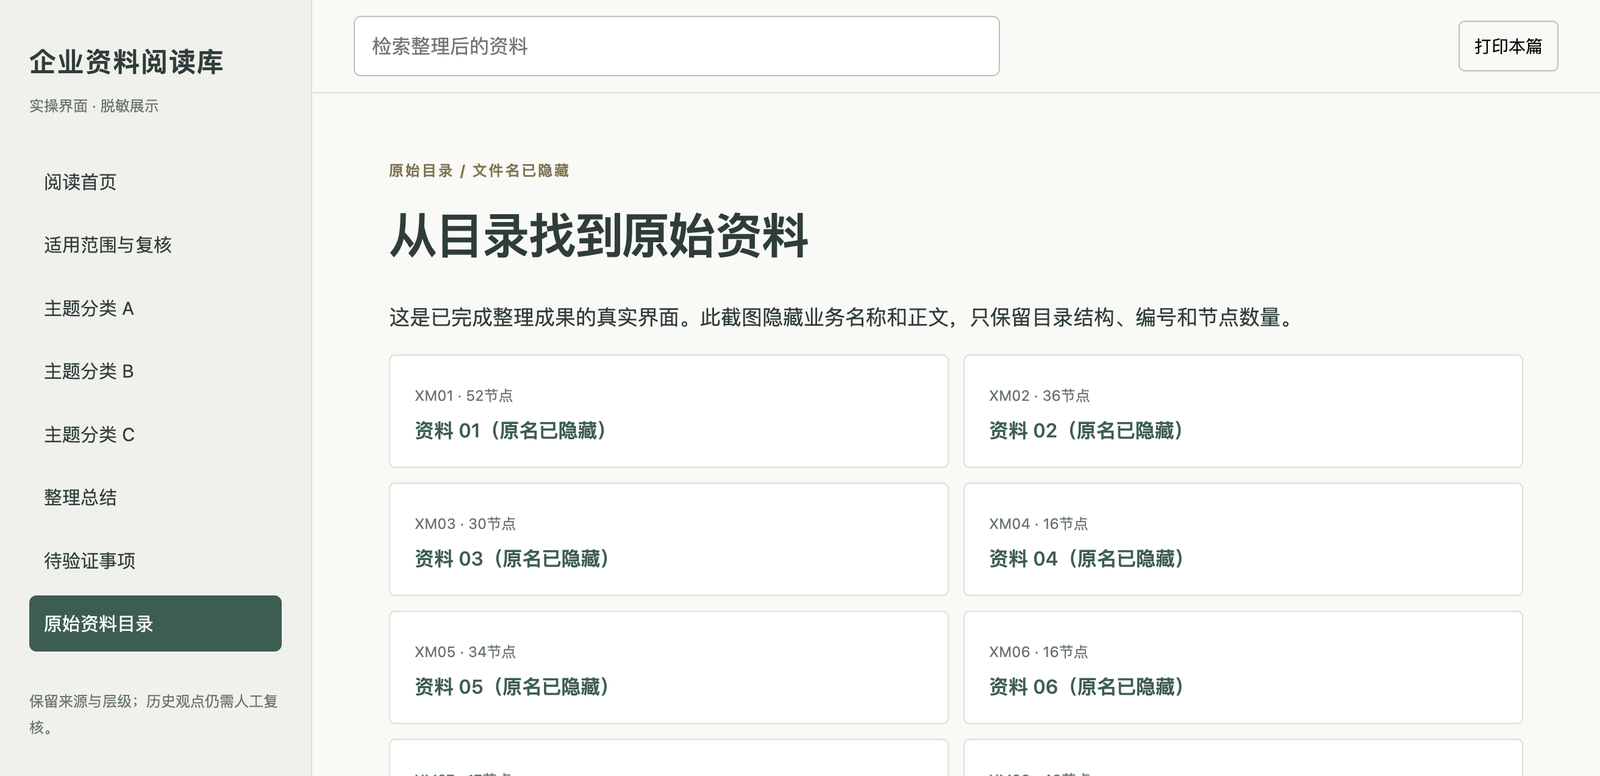
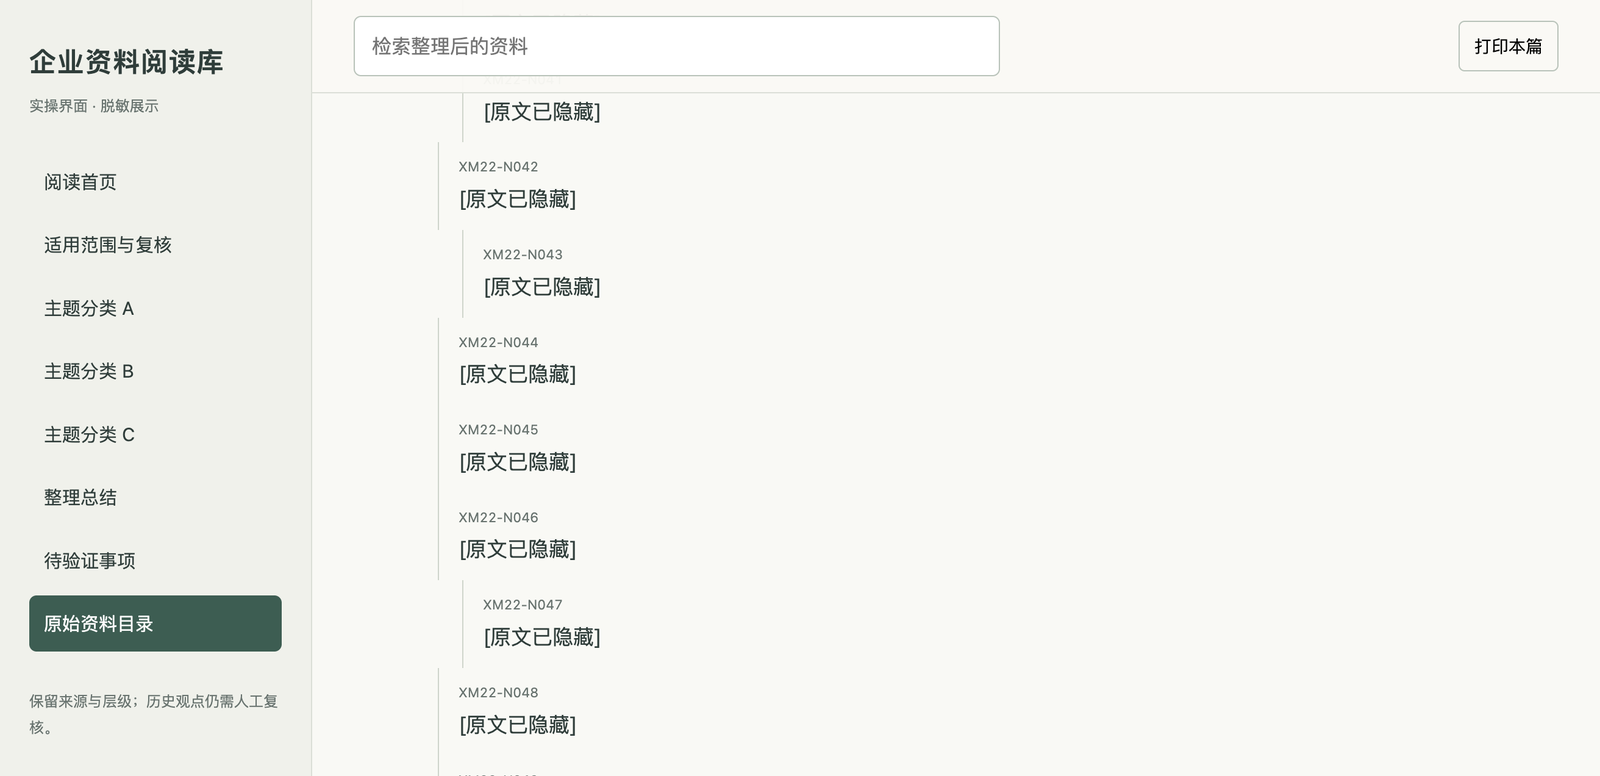
AI が文書を件名ごとに分類し、キーワード索引を作成します。どのバージョンが有効で、どのコンテンツを公開してもよいかを人間が確認します。答えが見つかったら、元のファイルに戻ることができなければなりません。
AI は情報を見つけやすくする責任を負い、人間はコンテンツが依然として正確で、適用可能で、公開されているかどうかを判断する責任があります。
このページには、完了した XMind データ収集の証拠のセットが表示されます。クラスは形式を制限しません。学生は、最初にこのメソッドを実行するために、一般的な PDF アルバム、Excel の見積書、Word の契約書、またはスキャンしたコピーを少量ずつ持参することができます。スキャンした原稿が識別できるかどうかを現場で確認させていただきます。
AI にファイルとフォルダーを調べて、最初の分類の提案を与えます。
各結果にソースを持たせると、元のファイルに戻って検証できます。
AI に独自にマージさせるのではなく、矛盾するコンテンツを選択し、他の人の判断を待ちます。
どのコンテンツが古い可能性があるか、どの情報が公開できないかを明確にします。
自分のファイルの小さなバッチをクラスに持ち込み、カタログ作成、キーワード検索、ソース トレースを練習します。規模は小さくても構いませんが、方法は完全でなければなりません。
解決したい問題、既存の教材、最終的に何を届けたいのかを説明し、適切なコースと練習方法を決定します。
トレーニングのニーズを伝える