Compter sur les gens pour se souvenir de l'emplacement des fichiers
Les informations sont dispersées dans différents dossiers et ne peuvent être trouvées si quelqu'un va et vient.
La méthode de recherche la plus longue dans l'entreprise est la phrase « probablement dans quel dossier il se trouve ». Nous conservons les originaux, créons de nouveaux répertoires et effectuons des recherches hors ligne : vous pouvez trouver des résultats en saisissant des mots-clés, et vous pouvez également revenir à l'emplacement des fichiers originaux. L’IA est chargée de catégoriser et de trier les conflits, et les humains jugent lesquels sont encore valables.
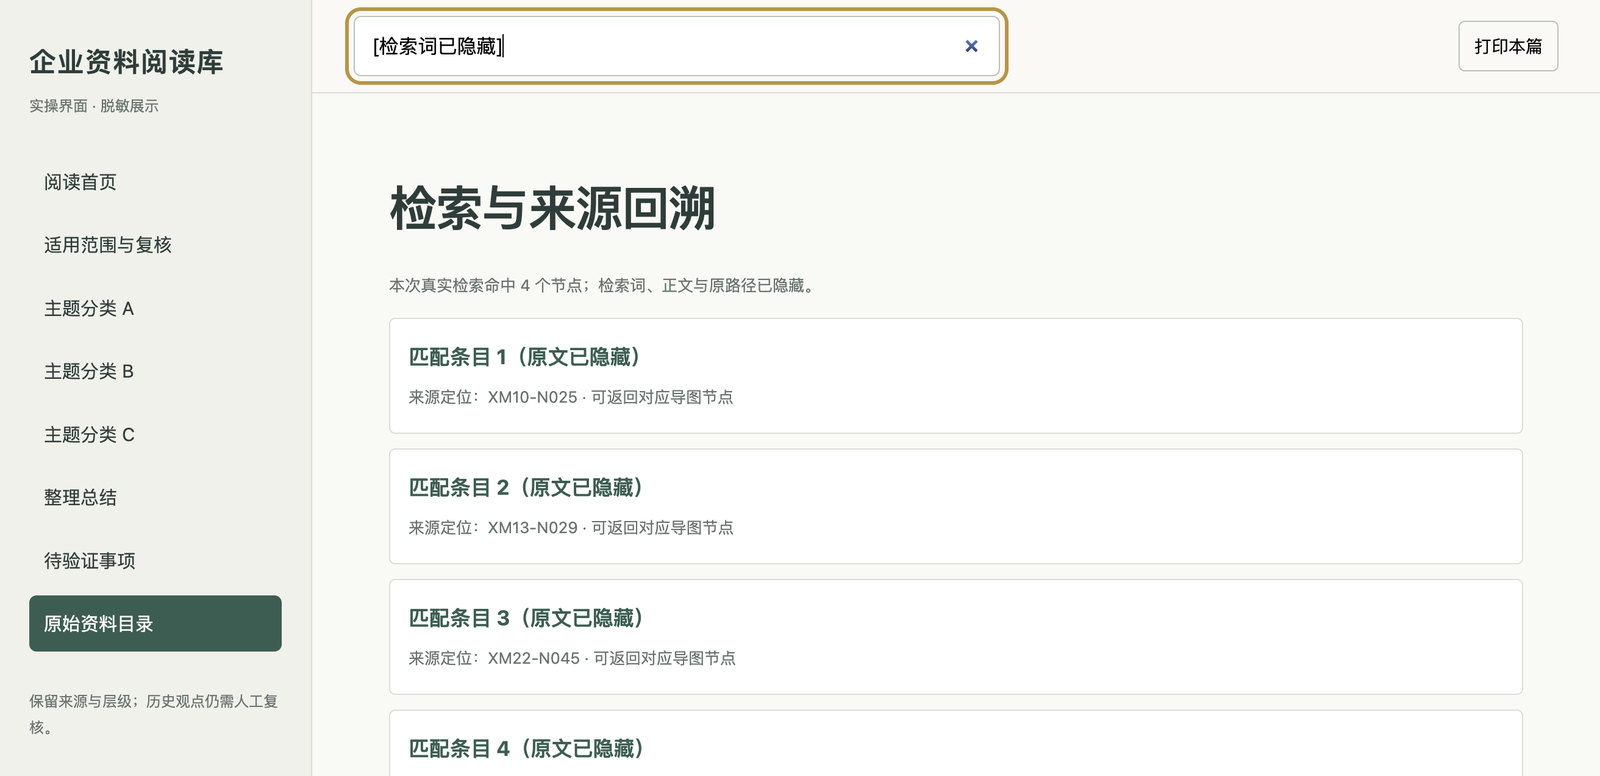
La structure des répertoires et le processus de récupération sont vrais, et le client et le texte interne sont masqués.
Chacun enregistre les fichiers selon ses propres habitudes et laisse plusieurs versions du même contenu. Même si vous trouvez la réponse, vous ne savez pas si elle est toujours valable ni où se trouve le texte original.
Les informations sont dispersées dans différents dossiers et ne peuvent être trouvées si quelqu'un va et vient.
Ils se ressemblent tous et il est difficile de dire lequel est le plus récent et lequel est obsolète.
J’ai trouvé une conclusion, mais je ne peux pas dire d’où elle vient ni où se trouvent les données originales.
Laissez les originaux seuls, créez un autre répertoire et effectuez une recherche hors ligne. Ce qui suit est le processus complet d’une recherche réelle.
Ces chiffres illustrent uniquement la portée de ce cycle de consolidation et ne signifient pas que tout le contenu a été vérifié.
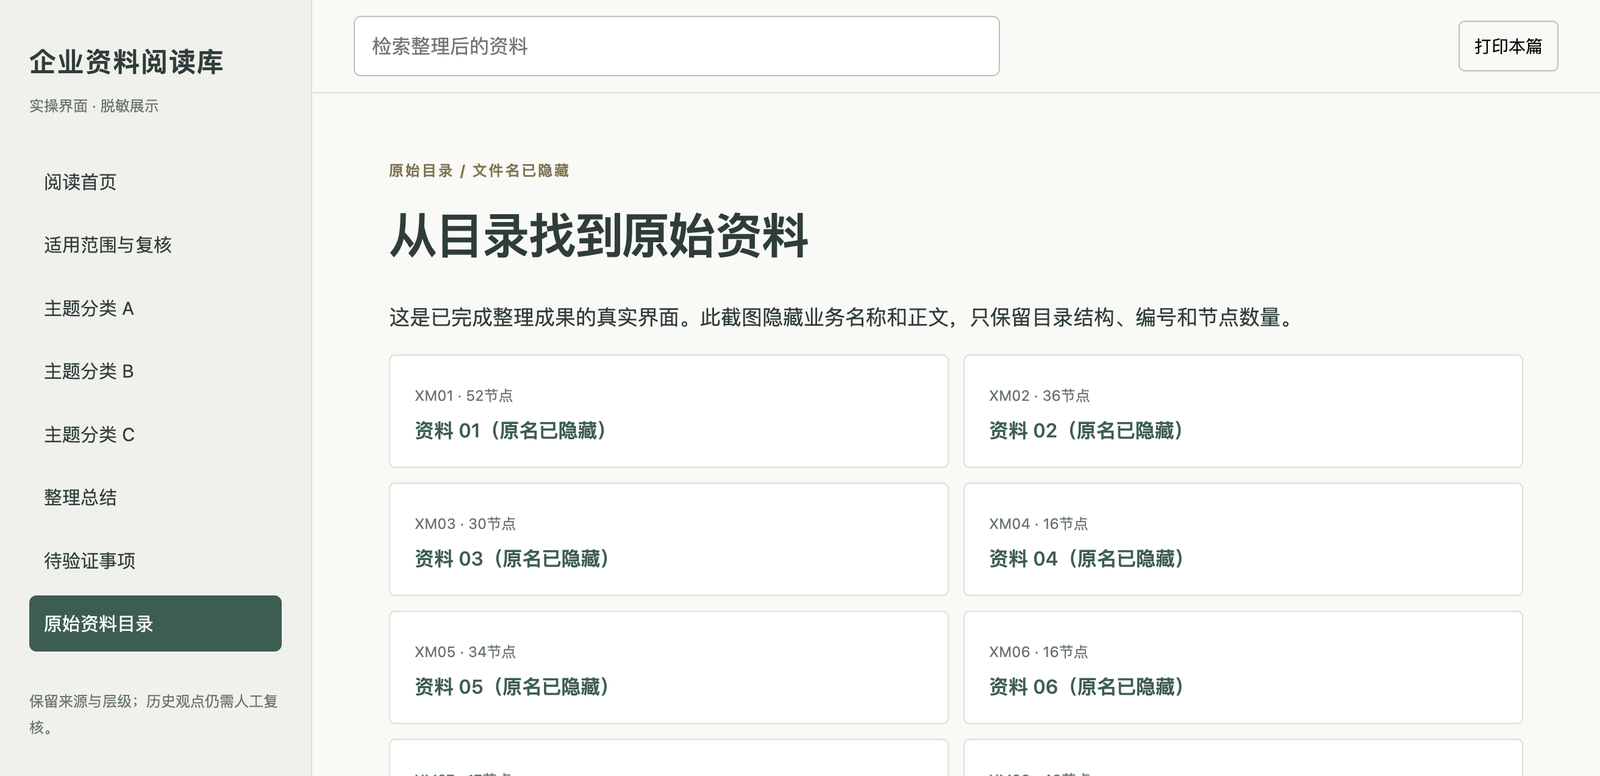
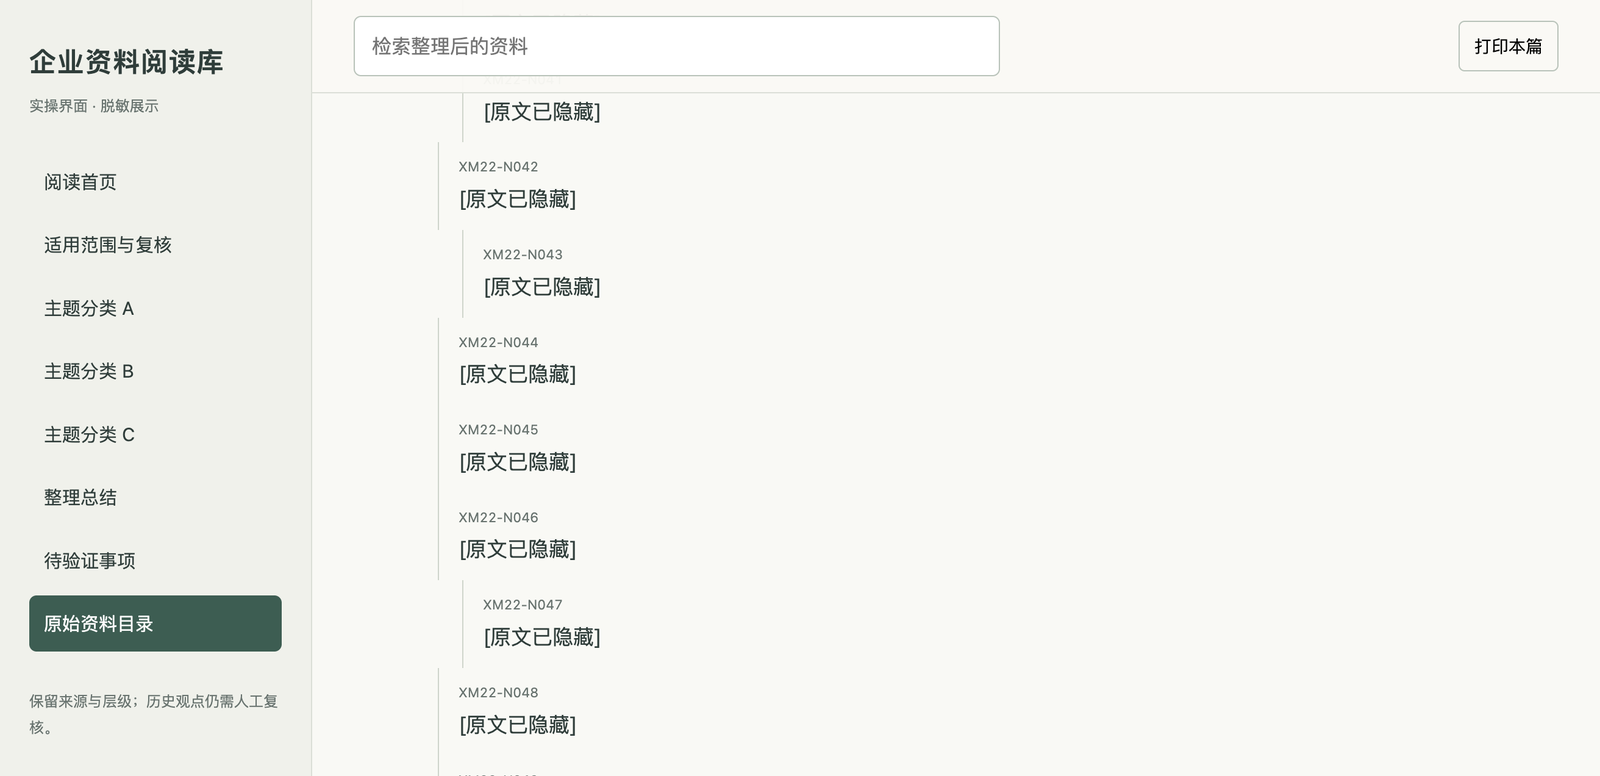
L'IA classe les documents par sujet et crée des index de mots clés ; les humains confirment quelle version est valide et quel contenu peut être rendu public. Lorsque la réponse est trouvée, il doit être possible de revenir au dossier original.
L’IA est chargée de rendre les informations faciles à trouver, et les humains sont chargés de déterminer si le contenu est toujours correct, applicable et public.
La page affiche un ensemble de preuves complétées de la collecte de données XMind ; la classe ne limite pas le format. Les étudiants peuvent apporter un petit lot d'albums PDF courants, de devis Excel, de contrats Word ou de copies numérisées pour parcourir la méthode en premier. La question de savoir si le document numérisé peut être identifié sera d'abord vérifiée sur place.
Laissez l'IA examiner vos fichiers et dossiers et vous donner des premières suggestions de catégorisation.
Laissez chaque résultat avoir sa source et vous pourrez revenir au fichier original pour vérification.
Identifiez le contenu conflictuel et attendez que les autres le jugent, plutôt que de laisser l’IA le fusionner elle-même.
Expliquez clairement quel contenu peut être obsolète et quelles informations ne peuvent pas être rendues publiques.
Apportez un petit lot de vos propres fichiers en classe et entraînez-vous au catalogage, à la récupération de mots-clés et au traçage des sources ; l'échelle peut être petite, mais la méthode doit être complète.
Expliquez le problème que vous souhaitez résoudre, le matériel existant et ce que vous souhaitez livrer au final, puis déterminez les méthodes de cours et de pratique appropriées.
Discuter des besoins de formation